La posición de Muse resulta relevante por su orientación como agente, una categoría que busca ir más allá de responder preguntas. Surfshark centra el análisis en qué ocurre con la información cuando el asistente necesita relacionar una solicitud con datos disponibles en otros servicios, esa capacidad amplía las posibilidades de uso, pero también obliga a examinar el alcance de los accesos y los fines declarados para tratar la información.
La comparación se refiere a las aplicaciones y a las categorías recogidas en sus fichas para el ecosistema de Apple, no debe trasladarse automáticamente a cualquier versión web, plataforma o modalidad empresarial de esos servicios. El resultado aporta una referencia sobre las declaraciones de privacidad analizadas, con las limitaciones propias de una comparación basada en ese conjunto de información.
Diferencias entre las aplicaciones analizadas
La media del conjunto se sitúa en 13 categorías, según la información facilitada por Surfshark, tanto las 31 atribuidas a Muse como las 33 de Meta AI superan ampliamente ese promedio. Por detrás aparecen Gemini, con 24 categorías; ChatGPT, con 17; y DeepSeek, con 14, en el otro extremo, Pi declara tres tipos de datos: identificador de usuario, interacción con el producto y registro de fallos, Duck.ai y Mistral Vibe figuran con seis categorías cada uno, seguidos por Grok AI, con siete, y Perplexity, con diez.
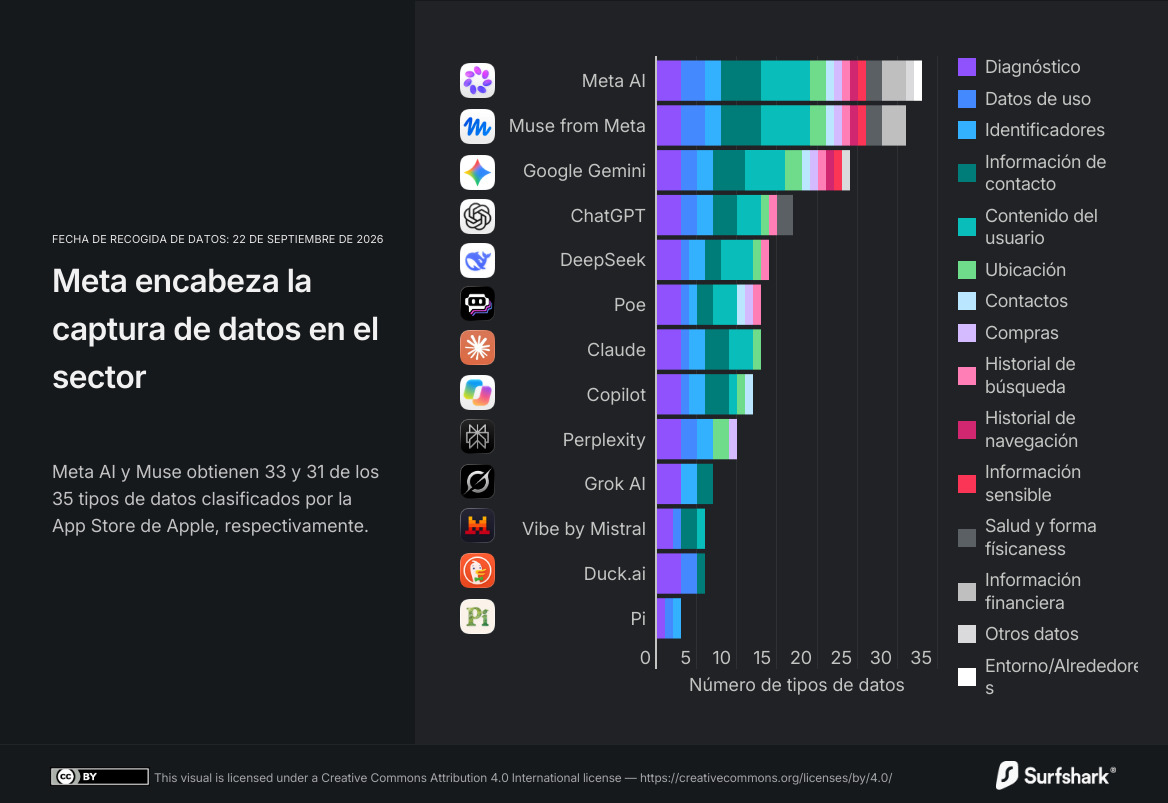
El salto entre la media de 13 categorías y las 31 de Muse equivale a más del doble de tipos declarados, Meta AI también supera ese umbral con 33 de las 35 categorías, cerca del 95% del total considerado. La distancia muestra una mayor amplitud de las declaraciones de Meta dentro del conjunto seleccionado, aunque las categorías no son unidades equivalentes de cantidad de información.
Un dato de diagnóstico y una categoría de ubicación, por ejemplo, describen información de naturaleza diferente, contar ambos como categorías permite comparar la extensión de las fichas, pero no pondera automáticamente la sensibilidad de cada uso. Por eso el análisis de localización e información sensible añade un matiz al recuento y ayuda a entender qué elementos concentran la advertencia de Surfshark.
Ubicación e información sensible
Surfshark identifica ocho aplicaciones con categorías de localización, en Gemini, Meta AI, Muse y Perplexity figura la ubicación precisa, mientras ChatGPT, DeepSeek, Claude y Copilot declaran ubicación aproximada. La presencia de estas categorías debe distinguirse del acceso permanente a la localización de cualquier usuario, que también depende de las funciones y permisos aplicables.
La categoría de información sensible aparece, según la investigación, en Gemini y en las dos herramientas de Meta, dentro de la clasificación utilizada puede abarcar datos sobre origen étnico, orientación sexual, creencias, afiliación sindical, opiniones políticas o información genética y biométrica. Su inclusión en una ficha tampoco significa que todos esos datos concretos se recopilen en cada interacción.
La distinción entre ubicación precisa y aproximada también cambia la lectura de los resultados, la primera declara un nivel de detalle mayor que la segunda, pero la ficha no demuestra por sí sola que la aplicación esté reconstruyendo los desplazamientos de todos sus usuarios. Para interpretar ese acceso importan tanto la categoría declarada como los permisos concedidos y el contexto de utilización.
La clasificación agrupa distintos tipos de datos bajo una misma categoría, de modo que su presencia exige atender a la finalidad y a la información que realmente se comparte, el recuento identifica aplicaciones que la contemplan, sin establecer que cada usuario haya proporcionado todos los elementos incluidos en ella.
Los agentes amplían la cuestión de los permisos
La evolución hacia asistentes capaces de ejecutar tareas introduce otra dimensión en el debate sobre privacidad, para actuar sobre servicios conectados, los agentes pueden requerir acceso a información de otras aplicaciones, además del contenido que el usuario introduce directamente en una conversación. Surfshark sostiene asimismo que las interacciones con Muse se utilizan por defecto para entrenar modelos de IA y que el usuario puede desactivar esa opción en la configuración. La compañía centra su advertencia en la combinación de datos disponibles y en el control sobre sus usos.
Surfshark diferencia además el acceso a información para realizar una tarea del uso de las interacciones para entrenar modelos, son dos cuestiones que el usuario puede percibir como parte de una misma conversación, aunque describen finalidades distintas. En el caso de Muse, la empresa de ciberseguridad afirma que el entrenamiento está activado por defecto y que puede deshabilitarse manualmente.







 Si (
 No(


